
Du livre scanné au document numérique structuré
OCRBookor vous accompagne dans la transformation de livres numérisés en PDF en documents numériques reconnus, reconstruits et exploitables. Découvrez une suite logicielle conçue pour faciliter le traitement et la valorisation des livres scannés, sans dépendance au cloud.
Pourquoi un PDF scanné ne suffit pas
Un fichier PDF constitué uniquement d'images brutes est inerte : le texte ne peut être recherché, les césures sont brisées et les liseuses ne peuvent pas le formater.
Texte inerte & invisible
Le texte ne peut pas être sélectionné, copié ou indexé par un moteur de recherche.
Inclinaison & Bruit optique
Les pages souffrent d'inclinaison (skew), de courbure de reliure et de taches de vieillissement.
Césures brisées & ponctuation
Les mots coupés en fin de ligne restent scindés et les règles typographiques françaises sont ignorées.
La solution OCRBookor
Calcul DPI, redressement automatique, binarisation Otsu, Tesseract v5 local, dé-césure et export EPUB 3 strict.
Le pipeline de traitement vérifié
1. Importer
Glisser-déposer de scans PDF, analyse des flux d'images.
2. Analyser
Calcul DPI, redressement Deskew et binarisation Otsu.
3. Reconnaître
Tesseract v5 100% local, indice de confiance mot à mot.
4. Reconstruire
Dé-césure, règles de l'Imprimerie Nationale, ligatures.
5. Exporter
EPUB 3 strict, Markdown Dublin Core, HTML5 et TXT.
Fonctionnalités réelles du logiciel
Traitement 100% Local
Tesseract WebAssembly & CLI. Zéro donnée transmise à des tiers.
Éditeur Bi-Fenêtre
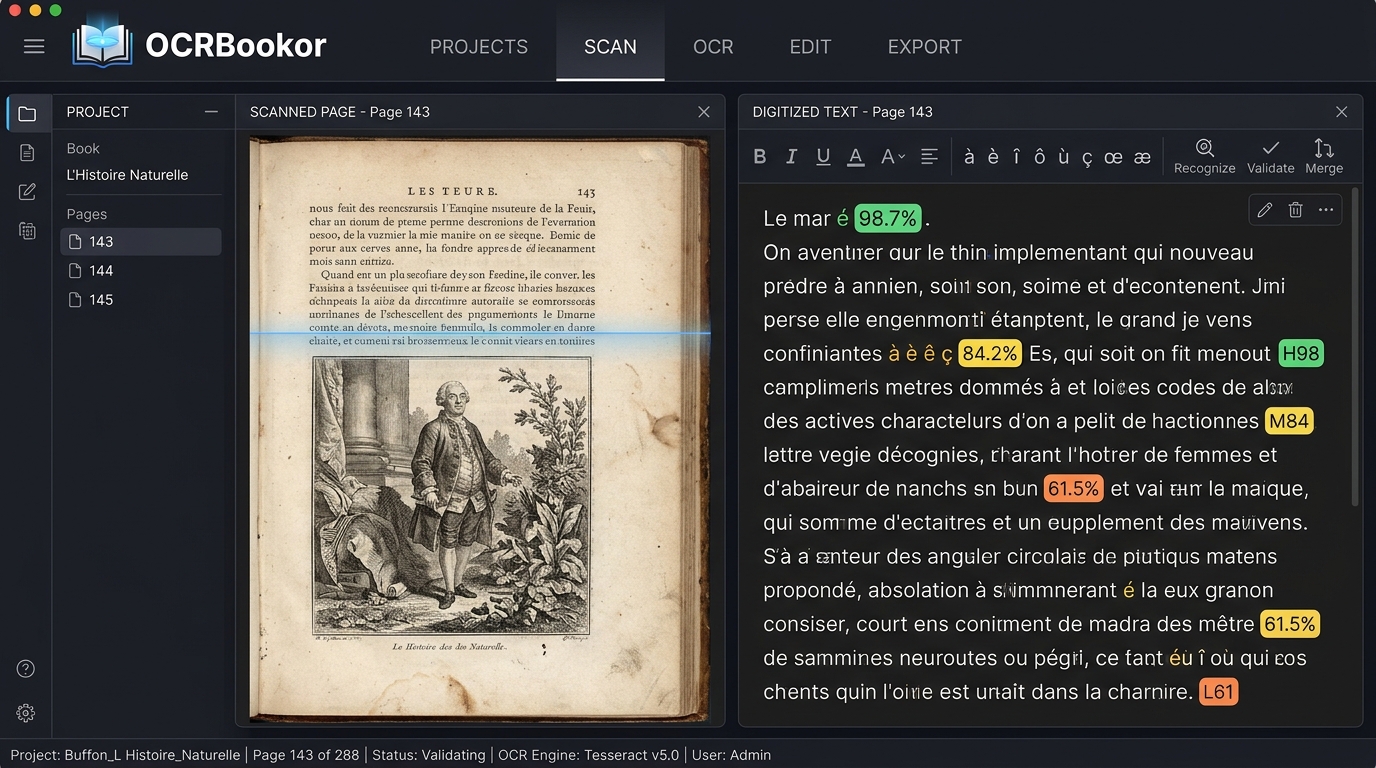
Scan original zoomable avec coordonnées spatiales vs texte éditable.
Typographie Imprimerie Nationale
Espaces insécables devant ! ? ; : % €, guillemets « », ligatures œ.
Dé-césure Intelligente
Recollage des mots coupés en fin de ligne avec respect des mots composés.
Planches & Illustrations
Extraction des gravures anciennes et association avec légendes.
Paquet Debian (.deb)
Intégration Linux avec lanceur /usr/bin/ocrbookor et raccourci bureau.
Documents obtenus avec OCRBookor
EPUB 3.3 Strict
Mimetype non compressé, container.xml, content.opf, nav.xhtml.
Markdown (.md)
Frontmatter Dublin Core YAML compatible Obsidian et Git.
HTML 5 Prêt
Page web autonome avec styles typographiques intégrés.
Texte Brut (.txt)
UTF-8 pur avec alinéas et paragraphes nettoyés.
Commencez à transformer vos livres scannés
Installez OCRBookor en une seule ligne de commande ou téléchargez directement le paquet Debian officiel.
Cette commande télécharge automatiquement la dernière version du binaire, l'installe proprement avec dpkg, résout toutes les dépendances et configure l'exécutable /usr/bin/ocrbookor :
curl -sSL https://raw.githubusercontent.com/nouhailler/OCRBookor/main/install.sh | sudo bash
ocrbookor prêt
Paquet Debian Autonome
Pour une installation hors-ligne ou archivage local du paquet binaire.
Dépôt GitHub & Exécution Node.js
Clonez le dépôt pour lancer le serveur local Express + Vite.
Foire aux questions
Qu'est-ce qu'OCRBookor exactement ?
Une suite logicielle locale permettant de transformer des scans PDF de livres en documents structurés EPUB 3, Markdown et HTML avec moteur de réconciliation bi-fenêtre.
Mes livres sont-ils envoyés sur internet ?
Non. OCRBookor fonctionne de manière 100% locale et hors-ligne via Tesseract v5 WebAssembly ou CLI natif.
Le logiciel lit-il l'écriture manuscrite ?
Non, OCRBookor v1.2.0 est conçu pour les textes imprimés au plomb ou contemporains.